2026-07-26|周日|公开电子杂志
早报|2026-07-26:台风、算力与数学叙事
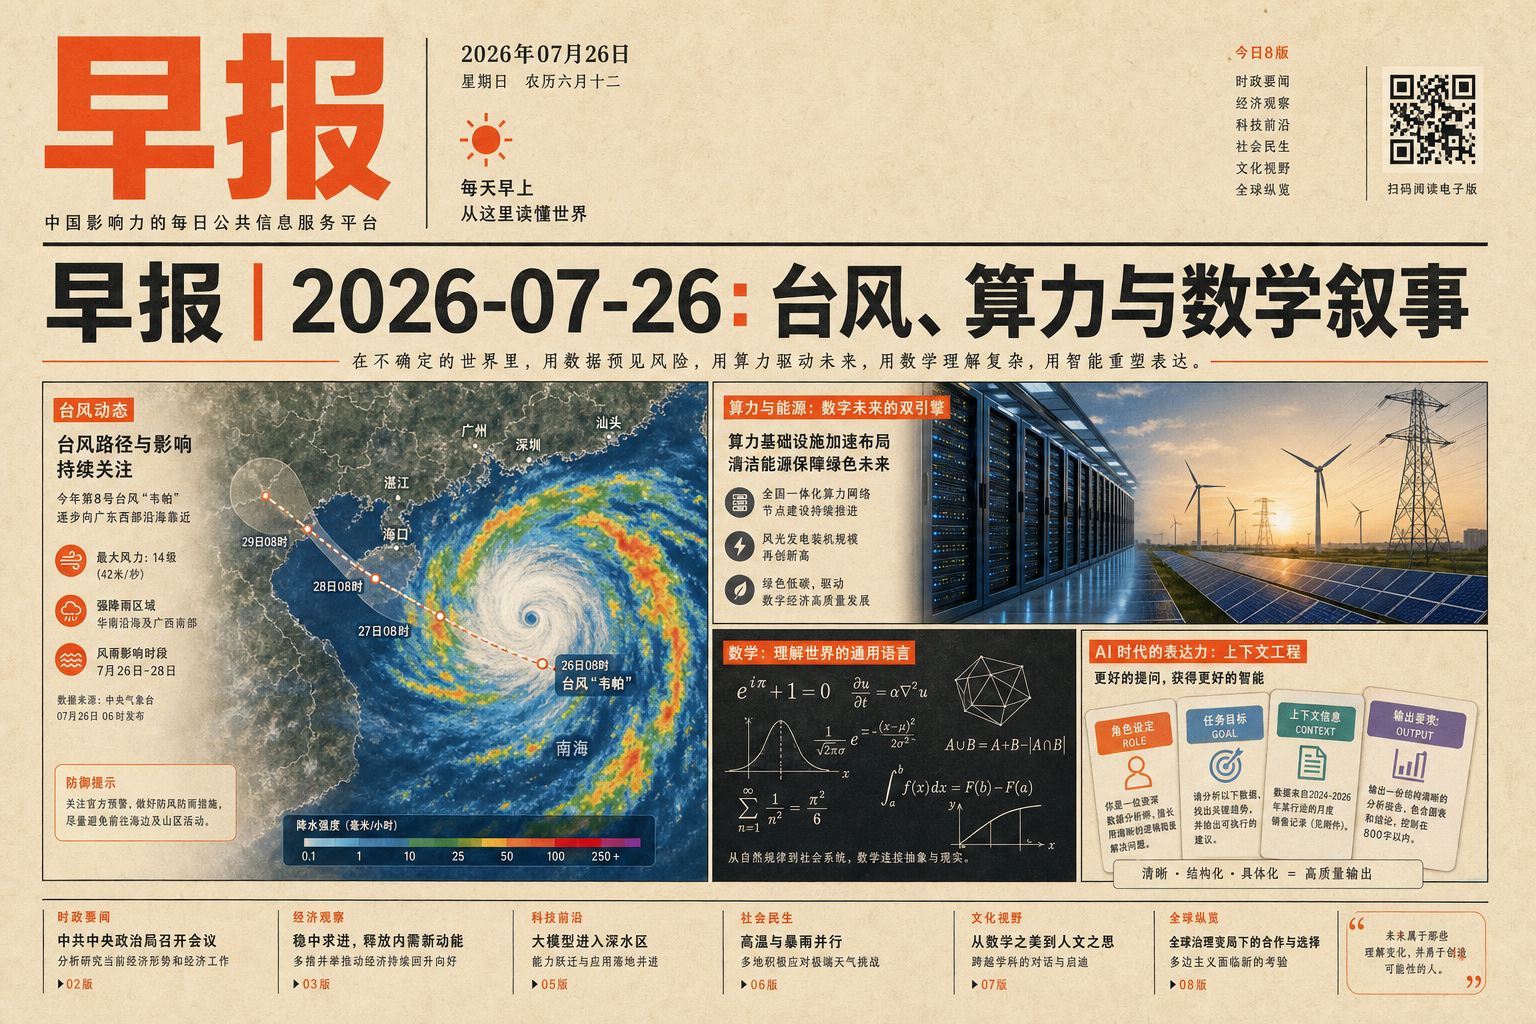
这个周日先从几件硬事开始:台风红霞登陆,华南交通和物流要看风雨;智能算力与电力装机继续上行,AI 的底盘问题更清楚。中文社区的热议分散在数学家的选择、暑期档撤档和大模型评测三处。本地生活只收录 7 月 26 日当天可执行活动。
今日判断
今天先看风雨和能源,而不是只看风险资产价格。
红霞登陆广东、香港风球和华南降雨会影响物流、航班与城市活动;同一天,国家能源局与工信部披露装机和算力扩张,说明实体约束比市场口号更实在。
中文互联网的周末议题都在翻旧成绩单。
数学家的选择、电影撤档和大模型讨论分别指向奖项、票房、榜单这三张成绩单;争论不在于数字还在不在,而在于它们还能不能说明真实质量。
沪杭今天适合选择时间明确、室内或固定场馆活动。
上海保留茶博会和舞台演出;杭州以大型演唱会和剧场演出为主。今日清单只放页面显示覆盖 7 月 26 日的活动。
宏观、金融与政策
台风“红霞”登陆广东,华南风雨进入今天的现实约束
中央气象台 7 月 26 日 6 时发布台风橙色预警,“红霞”凌晨在广东惠州登陆,登陆后强度减弱但降雨影响仍会深入内陆。它对市场和城市生活的意义很直接:短期看交通、港口、保险和华南线下活动,别把天气只当背景噪声。
来源:东方财富快讯/央视新闻
智能算力规模同比增长 177%,算力建设进入利用率考题
工信部披露,截至 6 月底我国智能算力规模达 2185 EFLOPS(FP16),全国算力设施整体上架率为 71.4%。数字本身很大,但更要看上架率、枢纽节点和真实工作负载,算力扩张已经从“有没有”转到“是否被有效使用”。
来源:东方财富快讯/人民日报
累计发电装机同比增 10.8%,新能源仍在改写电力底盘
国家能源局数据显示,截至 6 月底全国累计发电装机容量 40.4 亿千瓦,太阳能和风电装机分别同比增长 15.8% 和 18.5%。这条和算力数据要放在一起看:AI 产业的瓶颈不只在芯片,也在电力、并网和利用小时。
来源:东方财富快讯/人民日报
携程被反垄断处罚,平台经济的“反内卷”开始落到具体公司
新浪财经 7 点快讯转述《人民日报》财经要点,市场监管总局依法对携程实施垄断行为作出行政处罚并责令整改。这不是一句泛泛的“平台治理”,而是在线旅游这种高频服务场景里,监管重新检查平台与商户、消费者之间的议价边界。
来源:新浪财经
美国对伊行动出现弹药约束叙事,油气和航运仍需看二次验证
东财与新浪快讯均出现美伊、以伊相关消息,其中美国是否扩大行动被防空弹药库存牵制。高风险地缘消息先按“供应链与能源风险提醒”处理;只有油价、保险费、运价出现同步反应,才算进入交易层。
来源:东方财富快讯/新浪财经
中文互联网热点 / 讨论场
柳智宇回应王虹邓煜获奖讨论:数学共同体里的“离开”与“留下”
发生了什么
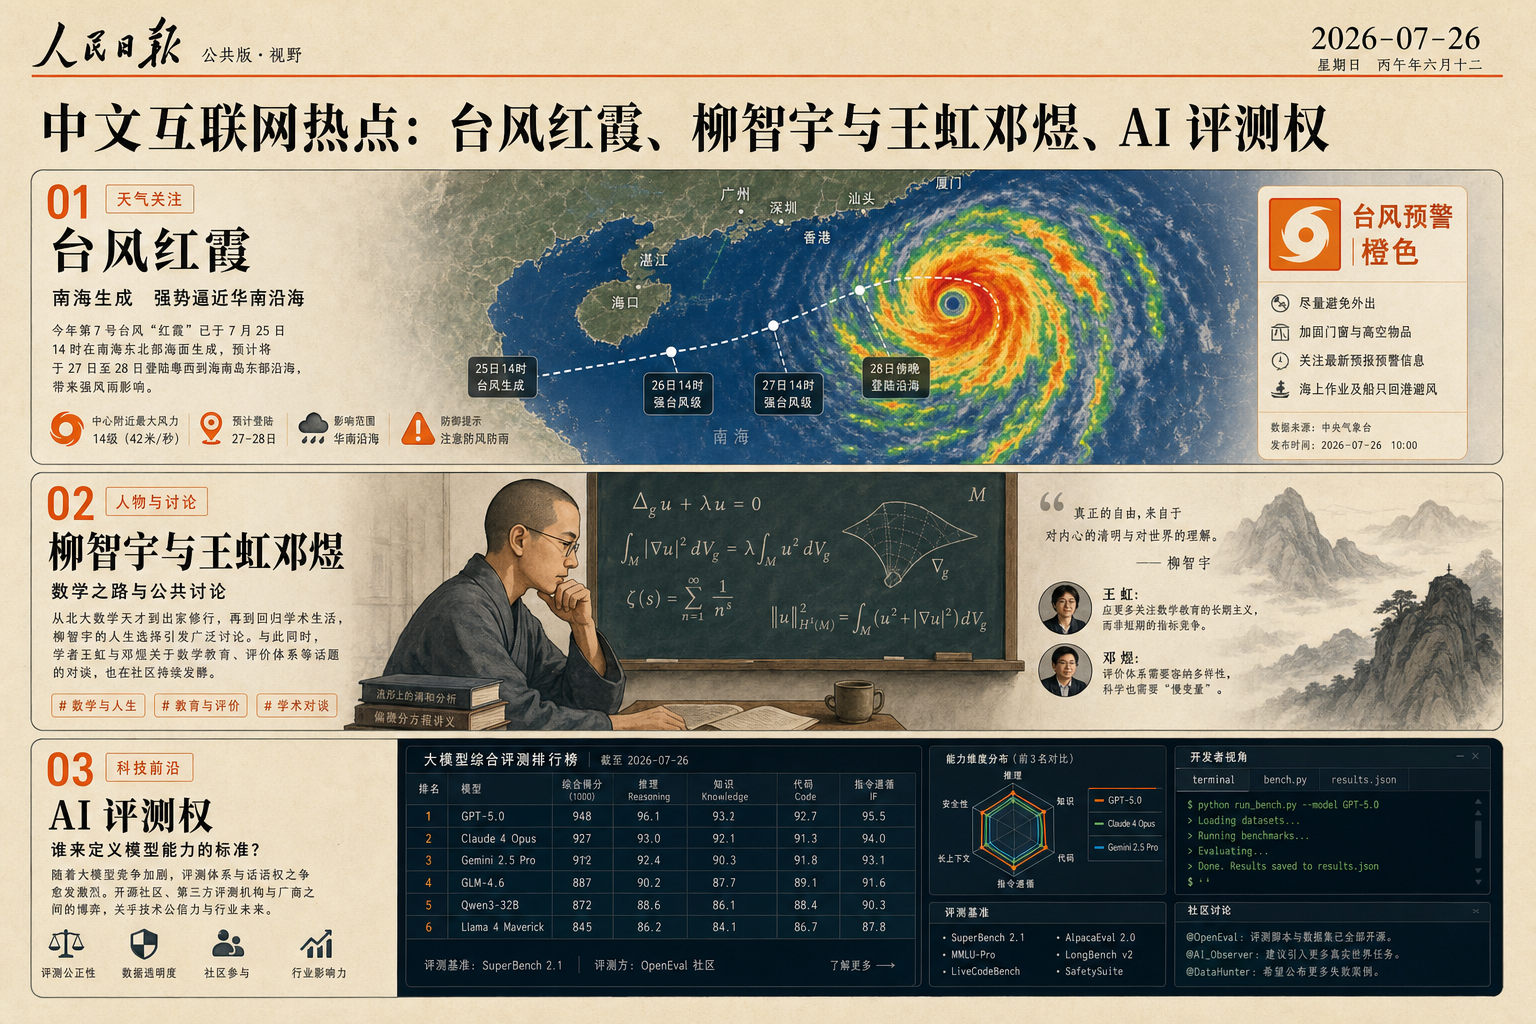
7 月 26 日早间,知乎热榜第一围绕“柳智宇评价同学王虹、邓煜获奖,并不后悔自己上山出家离开数学”展开。这个话题把前一天的数学人物讨论往更复杂处推了一步:很多人不只谈荣誉,也在比较几种人生路径。参与方包括北大数学共同体、柳智宇个人经历以及围观者对“天才叙事”的投射。争议点在于,离开顶级学术轨道到底是损失、自由选择,还是另一套价值排序。它能继续留在热榜,是因为这不只是“同学获奖、他去出家”的戏剧对照,也牵出公众对天赋、训练和退出权的焦虑。
讨论场
知乎侧重解释数学训练和个人选择,回答往往把“共同体资源、导师、问题品味”写得比传奇更重要;微博更容易把话题压缩成获奖与出家的戏剧对照;36氪用“王虹,慢慢想”补了一层人物叙事。百度实时榜的主流注意力更偏台风和民生,这说明数学话题在知识社区更热。获奖事实、论文贡献和当事人表述应以官方名单、一手文本与同行评价为准;社区讨论只能说明公众怎样理解成功与退出。
近模型:职业锦标赛模型(原领域:劳动经济学)
顶尖数学像高淘汰率锦标赛,早期训练、导师网络和问题选择会决定进入下一轮的概率。柳智宇话题刺痛公众,是因为同样从顶尖训练体系里出发,有人继续走学术竞赛,有人转向另一种生活,这才让争论被反复点燃。
远模型:生态位分化(原领域:生态学)
同一生态系统里,物种不只争同一种资源,也会通过分化栖位降低竞争压力。映射到个人路径,数学共同体、宗教修行和公共写作不是同一奖杯的不同名次,而是不同生态位;这个说法能解释选择,但不能替代数学共同体对成果的专业判断。
模型边界
锦标赛模型能解释高端科研为什么残酷,生态位分化补上个人价值排序的部分。二者共同解释不了具体论文的原创性,也解释不了当事人内心经验;那需要一手文本和同行评议。
下一组变量/验证点
后续可以看三件事:采访是否提供更完整的一手表述;高校是否把讨论转化为低年级科研训练机制;公众叙事是否从“天才对照组”转向培养条件与退出权。
来源:知乎热榜
《三国第一部:争洛阳》撤档讨论:历史 IP 不能只靠熟悉感续命
发生了什么
知乎热榜第二围绕“《三国第一部:争洛阳》上映 16 天后撤档、票房未破亿”的说法展开讨论。公开稿先把它作为社区议题处理:撤档公告、票房和排片仍需以片方与票务平台数据为准。真正有价值的问题不在一部电影单独失利,而在历史大 IP 的供给错配:观众认得三国人物,却不一定愿意为一套新的系列电影预付信任;片方用“第一部”建立长期叙事,市场却按单片完成度和口碑即时结算。争议点包括宣发节奏、改档是否有效、视效和剧作是否撑得起系列野心。
讨论场
知乎侧更集中在剧作、档期和系列化策略,讨论“撤档能不能救”;微博更偏票房结果和观众情绪,传播速度快但判断颗粒较粗;百度实时榜若给出电影关键词,更多代表大众搜索意图。“不好看”“被背刺”这类表达是观众情绪,不是单独事实。
近模型:实物期权模型(原领域:金融工程)
从片方角度看,撤档更像是在止损:继续烧宣发未必能换来票房,改档则是把问题往后推,等待一次重新包装的机会。这个模型解释的是投资时点,不等于影片质量会自动修复。
远模型:剧场调度中的换景时间(原领域:舞台管理)
舞台换景不是暂停表演,而是把观众注意力从上一幕安全转到下一幕。系列电影若没有完成这一转换,熟悉的三国人物反而会变成负担:观众认得名字,却没有被说服为什么还要再看一遍。这个视角解释体验断裂,不能直接推出票房规模。
模型边界
实物期权解释片方为什么撤档,剧场调度解释观众为什么没有进入新系列。二者都解释不了影片具体创作质量的每个细节,仍要回到文本、排片和真实口碑曲线。
下一组变量/验证点
后续是否继续发酵,主要看改档后是否重剪或重做宣发、二轮上映排片是否回升、长视频和短评平台的低分原因是否从宣发转向剧作本身。
来源:知乎热榜
Claude Opus 5、Kimi K3 与开源模型声量:AI 竞争的焦点变成评测权
发生了什么
36氪热榜继续围绕 Claude Opus 5、Kimi K3 和开源模型讨论,Hacker News 今日高位条目则是 Claude 5 系列的上下文工程文章。中文区关心国产模型、开源声量和创始人叙事,英文开发者社区更在意上下文工程、真实工作流和价格。争议点在于,模型强弱已经无法由单次演示决定:长上下文、工具调用、成本、可部署性、开放权重和政策风险共同组成新的比较框架。这轮讨论的新变化在于,大家不只问哪个模型更强,也开始争论用什么任务、什么成本、什么场景来判定强弱。
讨论场
36氪把 Claude、Kimi 和黄仁勋力挺开源放进同一科技叙事,适合观察中文 AI 产业传播;Hacker News 围绕上下文工程的具体做法讨论,代表开发者采用门槛;Product Hunt 上 OpenComputer、Heard、ADE 等工具说明 agent 操作层还在扩张。百度热榜若出现创始人或模型关键词,更多说明大众注意力会把技术更新转成可讲述的人物故事。真正能定分歧的,还是公司文档、第三方长任务测试,以及开发者在真实项目里的复现结果。
近模型:测量有效性模型(原领域:心理测量学)
测试若只测到容易量化的部分,就会把“分数高”误写成“能力强”。大模型竞争的关键不只是榜单,而是测试是否覆盖长任务、工具恢复、上下文污染和成本边界。Claude 与 Kimi 的争论,本质上是在争量表是否仍然有效。
远模型:材料疲劳试验(原领域:材料工程)
材料不是一次拉伸就被定义,而是在反复载荷下暴露裂纹。模型也一样,真正差异会在多轮调用、长任务、边界输入和预算压力下显现。这个模型能迫使讨论从截图回到连续使用,但不能忽视模型会快速更新,样本不像材料那样稳定。
模型边界
测量有效性解释为什么榜单会误导,疲劳试验补上真实使用中的反复压力。二者共同解释不了商业采购中的组织惯性,也解释不了监管对开放权重的最终口径。
下一组变量/验证点
后续重点看第三方长任务评测、API 价格和限流、开源权重商业部署规则、开发者是否把上下文工程变成团队规范而不是个人技巧。
来源:36氪
上海、杭州今天可以做什么
今天只按 7 月 26 日安排;表格保留时间、场馆和来源相对清楚的条目。
上海
| 时间 | 活动 | 地点 | 价格/预约 | 来源 | 展开 |
|---|---|---|---|---|---|
| 7 月 26 日|白天 | 2026 第三十届上海国际茶业交易博览会 | 上海展览中心 | 展会入场信息见入口页;页面未列单场票价 | 一展网 | |
| 展期覆盖 7 月 23 日至 26 日,适合关注茶饮、礼品和线下消费渠道的人把周日下午留给展会;出行前重点看闭馆时间与入场登记。 | |||||
| 7 月 26 日|日间 | 《华人之光·芭蕾明星 GALA》 | 上海大剧院 | 票务页确认场次与余票;公开摘要未列准确开场时间 | Trip.com 活动页 | |
| 页面显示 7 月 25 日至 26 日,适合想看舞台艺术而不愿在台风外围天气里安排户外活动的人。 | |||||
杭州
| 时间 | 活动 | 地点 | 价格/预约 | 来源 | 展开 |
|---|---|---|---|---|---|
| 7 月 26 日|晚间 | 许嵩 2026《安泊猜想》巡回演唱会杭州站 | 杭州奥体中心体育场(大莲花) | 票务页确认座席与入场;搜索摘要显示 19:00 档期信息 | Trip.com 活动页 | |
| 页面显示 7 月 24 日、26 日抵达杭州,是今天最明确的大型演唱会条目,适合已有购票计划的人安排夜间出行;散场交通压力需要预留。 | |||||
| 7 月 26 日|日间/晚间 | WetMen 俄罗斯型男水舞剧《雨中 2:爱的宣言》 | 杭州东坡大剧院 | 票务页确认场次与余票;公开摘要未列准确开场时间 | Trip.com 活动页 | |
| 页面显示 7 月 23 日至 26 日,适合偏好剧场和舞台表演的人选择室内活动。 | |||||
AI、科研与开发者工具
今日新论文
Tencent WorkBuddy Bench: A Multi-Domain Coding-Agent Benchmark with Contamination-Resistant Task Construction
腾讯团队把 coding agent 评测做成多领域任务,并强调抗污染构造,重点不再是单题演示。 代码智能体进入采购和团队使用前,需要这种更接近真实工作的评测。
来源:arXiv
Frontier Financial Judgement: Can agents tell what might move a stock?
论文追问智能体能否判断哪些信息会推动股价,正好连接金融文本理解和决策评测。 如果评测成立,金融智能体的价值会从摘要转到“区分可交易信息”。
来源:arXiv
CAMeR: Keyword-Gated Hybrid Activation for Adaptive Memory Retention in LLM Agents
论文用关键词门控来管理智能体记忆激活,目标是减少长期任务里的无关上下文干扰。 它给 agent memory 提供了一个更工程化的方向:不是越多越好,而是按任务激活。
来源:arXiv
One More Turn, Less Regret: A Regret-Based Multi-Turn Benchmark for LLMs’ Clarification Policies
论文评估模型何时应该多问一轮澄清,避免在信息不足时过早给答案。 这类评测直接影响客服、搜索和代码助手的交互质量。
来源:arXiv
社区早期信号与产品
Claude 5 系列上下文工程规则在 HN 引发开发者讨论
HN 第三位指向 Claude 官方文章,讨论集中在长上下文、指令分层和实际工作流。它更像开发者采用信号,不是单独能力证明。
来源:Hacker News
OpenComputer 登上 Product Hunt 首位,agent 部署开始产品化
OpenComputer 的定位是托管式 agent 部署;同日 Product Hunt 还有 Heard、ADE 等围绕 Codex、Claude Code 的产品。工具层的竞争正在从“模型聊天”转向“如何管理一组 agent”。
来源:Product Hunt
钠离子电池用于美国电网储能,开发者社区也在关注能源底盘
HN 首位是 IEEE Spectrum 关于 GM 支持钠离子电池电网储能的文章。它和今天的国内装机数据可以互相参照:AI 与电气化都在把储能变成基础设施问题。
来源:Hacker News
今天可以继续追的线索
华南风雨看航班、港口和物流延误;算力与电力合并看上架率和电价;AI 模型讨论看长任务评测和价格限流。